はじめに
昨今のAIブームで各社がしのぎを削っている.クラウド上で動作するAnthropicやOpenAIをはじめとしたAIモデルがある一方で,オープンソースでローカルで動作するモデルも実行環境が整ってきている.
今回は AMD RX9060TX で Ollama を使う環境を整備する.
環境
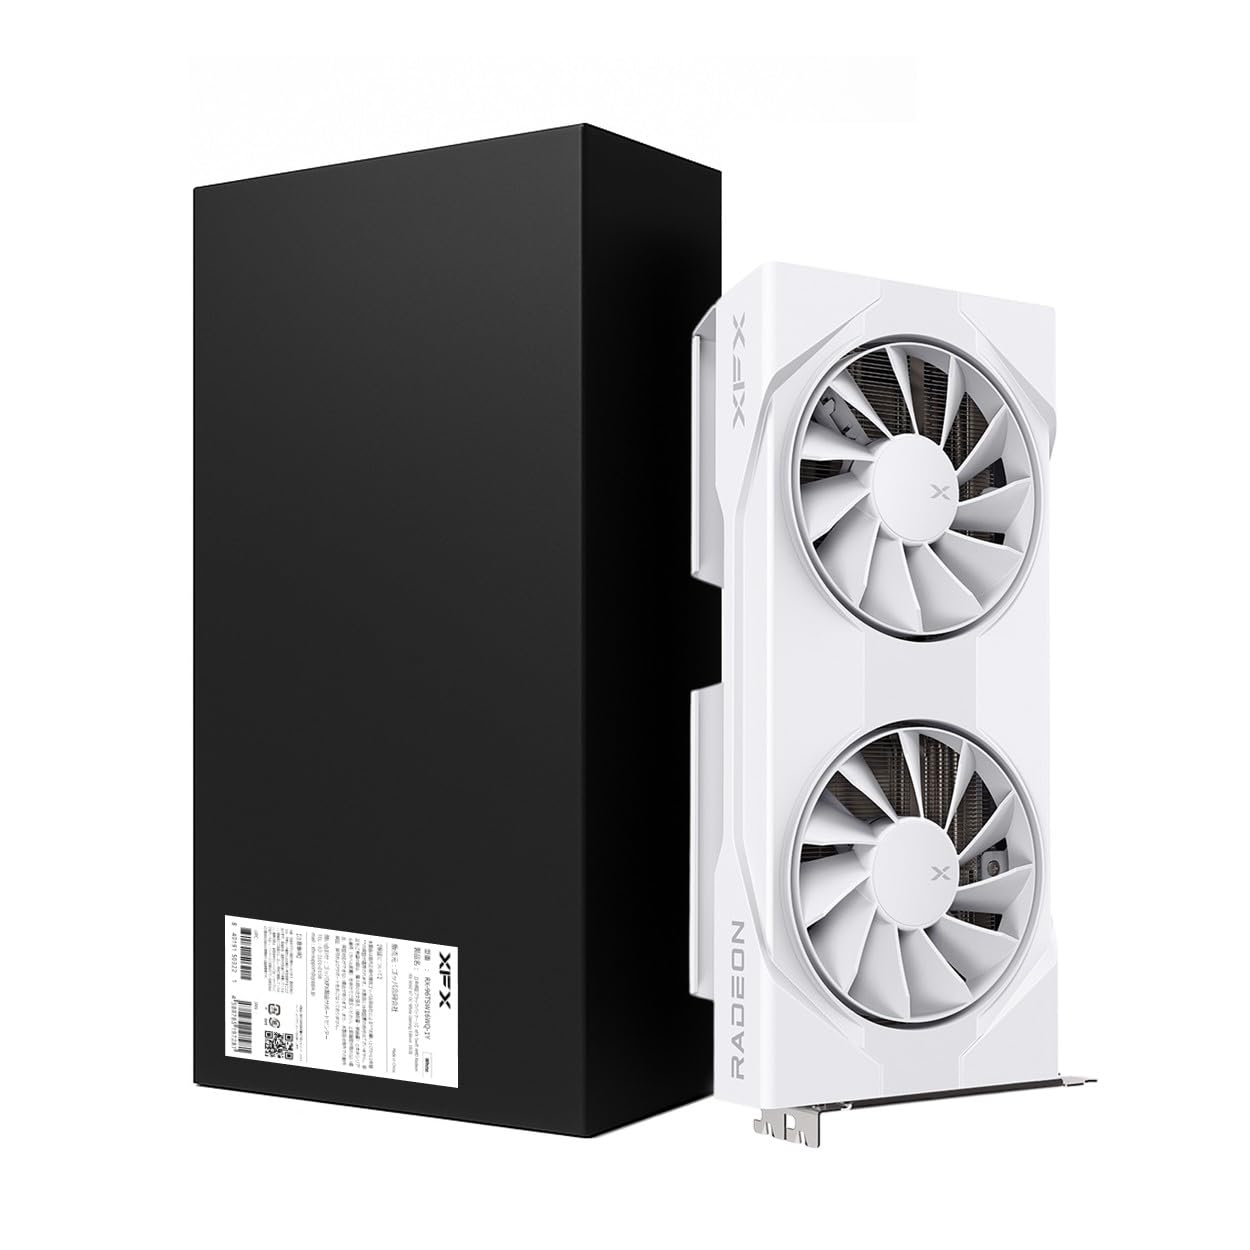
今回使うのは XFX RX9060TX16GB.昨今GPUの価格が高騰する中,ミドルクラスで比較的安価.
$ lscpu
Architecture:                x86_64
  CPU op-mode(s):            32-bit, 64-bit
  Address sizes:             39 bits physical, 48 bits virtual
  Byte Order:                Little Endian
CPU(s):                      8
  On-line CPU(s) list:       0-7
Vendor ID:                   GenuineIntel
  Model name:                Intel(R) Core(TM) i7-9700K CPU @ 3.60GHz
<中略>
$ lsmem
RANGE                                 SIZE  STATE REMOVABLE  BLOCK
0x0000000000000000-0x000000007fffffff   2G online       yes   0-15
0x0000000100000000-0x000000047fffffff  14G online       yes 32-143

Memory block size:                128M
Total online memory:               16G
Total offline memory:               0B
$ lspci | grep -i radeon
03:00.0 VGA compatible controller: Advanced Micro Devices, Inc. [AMD/ATI] Navi 44 [Radeon RX 9050 / 9060 XT] (rev c0)
$ cat /etc/fedora-release
Fedora release 44 (Forty Four)
Ollama 概略
Ollamaは自身のコンピュータ上でAIモデルを実行するためのOSS.
AnthropicではOpusやSonnetといったモデルがあるように,Ollamaでもオープンソースで提供されているモデルがいくつかある.ClaudeCode,OpenCode,Hermes,OpenClawなどとも連携できる.
大まかな分類と用途
Ollama.comで公開されているモデル一覧だけ見ても何を使ったらいいかわからない人のために,モデルとその用途と適当に分類しておく.一部のモデルはクラウド専用のものもあるので注意.
| モデル | 分類 | 用途 |
|---|---|---|
| GLM / Laguna / Kimi / Qwen / North Mini Code / Ornith / Nemotron / Muse Glimmer / MiniMax / Devstral / gpt-oss | コーディング エージェント作業 | 長時間のコード生成・修正,ツールを使った自律エージェント,ソフトウェア開発全般 |
| MiniCPM-V / MedGemma / Gemma / Nemotron / GLM-OCR / DeepSeek-OCR | マルチモーダル | 画像理解,動画解析,医療画像,OCR,視覚情報を含むタスク |
| LFM / Granite(小サイズ) / Qwen(小サイズ) / MiniCPM-V / Ministral | 軽量/高速 | ノートPCや低スペック環境,リアルタイム応答が欲しい人 |
| Granite / Mistral | エンタープライズ | 業務利用,多言語対応,RAG,JSONなどの構造化データ生成 |
| Nomic Embed | 埋め込み 検索特化 | ベクトル検索,類似度検索,RAGの埋め込み部分 |
| TranslateGemma | 翻訳 | 多言語翻訳 |
| Granite Guardian / GPT-OSS Safeguard | 安全性チェック | LLMの出力が有害かどうか判定する安全性評価 |
主要なモデル
Ollamaで利用できる日本製のモデルは,更新頻度が低かったり,既成モデルの派生だったり,あまり目立ったモデルがなくて悲しい状況.こういう分野は人的にも資金的にも莫大な開発リソースを投入できる中国はめちゃくちゃ強い.ロボットの変な走り方を笑いものにしているような人たち,到底追いつけないほどに周回遅れの技術レベルになってからではすべてが遅いと危機感を覚えたほうがいい.と痛烈に思う今日この頃.
| モデル | 提供元 | パラメータ数 目安 | モデルサイズ 目安 | 用途/特徴 |
|---|---|---|---|---|
| GLM | Z.ai (中国) | 超大規模 (クラウド) | – | コーディング性能トップクラス.長時間エージェント・複雑コーディングに強い. |
| Qwen | Alibaba (中国) | 中規模 (27B) | 約16〜18GB | バランスが良く人気.コーディング・エージェント・ビジョン対応. |
| Laguna | Poolside AI (米国) | 33B〜118B | XS:約20GB S:約75〜96GB | コーディング・長時間エージェント特化.ローカル実行を意識した設計. |
| Kimi | Moonshot AI (中国) | 超大規模 (クラウド) | – | 長時間コーディング・大規模リポジトリ・ネイティブマルチモーダル(画像・動画). |
| gpt-oss | OpenAI (米国) | 20B / 120B(MoE) | 20B:約14GB 120B:約65GB | 強力な推論・エージェント・開発者向け汎用.思考努力度調整可能.テキスト専用. |
| Gemma | 小型〜中規模 | 4B:約3GB 12B:約7〜8GB 27〜31B:約17〜19GB | Google Geminiのオープンソース版.推論・エージェント・マルチモーダルに強い.医療系のMedGemma,翻訳特化のTranslateGemmaなどの派生がある. | |
| Muse Glimmer | Meta (米国) | 30B | 約17〜18GB | 常時稼働ローカルエージェント向け.ツール利用・失敗リカバリに強い.マルチモーダル. |
| Granite | IBM (米国) | 3B〜30B | 3B:約2GB 8B:約5GB 30B:約16GB | 企業向け。多言語・RAG・構造化出力に強い. |
| MiniCPM-V | OpenBMB (中国) | 1B〜8B | 約2〜6GB | 軽量ビジョンモデル.画像・動画理解を低スペック環境で可能に. |
| North Mini Code | Cohere | 30B(MoE) | 約19GB | エージェント的ソフトウェアエンジニアリング特化. |
※ビジョン対応:テキストだけでなく,画像や動画入力に対応しているモデル
※MoE:Mixture of Experts(混合専門家モデル)
ここで表している「規模目安」はモデルのパラメータ数を表す.高度なモデルほど,パラメータ数が多くなり,個人のローカルリソースでは実行が困難になる.量子化方式によってモデルサイズは変わるものの,今回用意した RX9060TX16GB で実行できるのはモデルサイズが15〜20GB程度の中規模モデルがしきい値になってくる.MoEのモデルの場合は,パラメータ数が多くても実稼働が少なく済むが,モデルサイズが小さくても,モデル自体がGPUに乗らない可能性もある.
Ollama インストール
Ollama のインストールガイドにしたがってインストールする.Fedora では dnf でもインストールできるが,公式のスクリプトからインストールすることをおすすめする.
Ollama is officially available only on Fedora 42 and above. Attempting to install on earlier versions may result in errors or broken dependencies.

やることは,インストールスクリプトを実行して,サービス起動するだけ.
$ curl -fsSL https://ollama.com/install.sh | sh
$ ollama serve
インストールスクリプト内でGPUを検出して,GPU関連のパッケージもインストールされる.
    277 check_gpu() {
    278     # Look for devices based on vendor ID for NVIDIA and AMD
    279     case $1 in
    280         lspci)
    281             case $2 in
    282                 nvidia) available lspci && lspci -d '10de:' | grep -q 'NVIDIA' || return 1 ;;
    283                 amdgpu) available lspci && lspci -d '1002:' | grep -q 'AMD' || return 1 ;;
    284             esac ;;
    285         lshw)
    286             case $2 in
    287                 nvidia) available lshw && $SUDO lshw -c display -numeric -disable network | grep -q 'vendor: .* \[10DE\    287 ]' || return 1 ;;
    288                 amdgpu) available lshw && $SUDO lshw -c display -numeric -disable network | grep -q 'vendor: .* \[1002\    288 ]' || return 1 ;;
    289             esac ;;
    290         nvidia-smi) available nvidia-smi || return 1 ;;
    291     esac
    292 }
    293
    294 if check_gpu nvidia-smi; then
    295     status "NVIDIA GPU installed."
    296     exit 0
    297 fi
    298
    299 if ! check_gpu lspci nvidia && ! check_gpu lshw nvidia && ! check_gpu lspci amdgpu && ! check_gpu lshw amdgpu; then
    300     install_success
    301     warning "No NVIDIA/AMD GPU detected. Ollama will run in CPU-only mode."
    302     exit 0
    303 fi
    304
    305 if check_gpu lspci amdgpu || check_gpu lshw amdgpu; then
    306     download_and_extract "https://ollama.com/download" "$OLLAMA_INSTALL_DIR" "ollama-linux-${ARCH}-rocm"
    307
    308     install_success
    309     status "AMD GPU ready."
    310     exit 0
    311 fi
今回インストールされたバージョンこちら.
$ ollama -v
ollama version is 0.34.4
Gemma4を動かす
Gemma(ジェマ)はGoogleが提供するAIモデルで,Geminiと同様の技術に基づく軽量なオープンモデル.Gemma4 ではすべてのモデルがビジョン対応している上,E2B/E4Bでは音声入力にも対応している.
Gemma4:8B
とりあえず何も考えないで run gemma4 を実行したら8B が動いた.軽快に動作してくれる.
$ ollama run gemma4
>>> /show info
  Model
    architecture        gemma4
    parameters          8.0B
    context length      131072
    embedding length    2560
    quantization        Q4_K_M
    requires            0.20.0

  Capabilities
    completion
    vision
    audio
    tools
    thinking
        levels     false, true
        default    true

  Parameters
    top_p          0.95
    temperature    1
    top_k          64

  License
    Apache License
    Version 2.0, January 2004
    ...

>>> Send a message (/? for help)
Gemma4:12B
放熱ファンが頑張ってくれて,一応動くけど,CPUもわりと使用率が上昇して,PC全体がややカクつき始める印象.intel第9世代ではそろそろCPUボトルネック気味かも...
~$ sudo amd-smi
+------------------------------------------------------------------------------+
| AMD-SMI 26.2.0+unknown       amdgpu version: Linuxver ROCm version: N/A      |
| VBIOS version: 00155323                                                      |
| Platform: Linux Baremetal                                                    |
|-------------------------------------+----------------------------------------|
| BDF                        GPU-Name | Mem-Uti   Temp   UEC       Power-Usage |
| GPU  HIP-ID  OAM-ID  Partition-Mode | GFX-Uti    Fan               Mem-Usage |
|=====================================+========================================|
| 0000:03:00.0  AMD Radeon RX 9060 XT | 1 %      62 °C   0            21/182 W |
|   0       0     N/A             N/A | 3 %     46.67           10312/16304 MB |
+-------------------------------------+----------------------------------------+
+------------------------------------------------------------------------------+
| Processes:                                                                   |
|  GPU        PID  Process Name          GTT_MEM  VRAM_MEM  MEM_USAGE     CU % |
|==============================================================================|
|    0     105873  llama-server           7.9 MB    7.9 GB     8.1 GB  N/A     |
+------------------------------------------------------------------------------+
Gemma4:26B
私の環境では無理.PC全体の動作に支障をきたし始めるレベルで動かないので中断.
~$ ollama run gemma4:26b
pulling manifest
pulling dfd98d273421: 100% ▕█████████████████████████████████████████████████████████████████████████████▏  16 GB
pulling 41926ed5f140: 100% ▕████████████████████████████████████████████████████████████████████████████ ▏ 1.2 GB/1.2 GB   41 MB/s      0s
pulling 6326fb9f5e48: 100% ▕████████████████████████████████████████████████████████████████████████████ ▏ 460 MB/461 MB   75 MB/s      0s
verifying sha256 digest
writing manifest
success
⠋ ^C
ということで,今の環境では,快適に動くのは8Bくらい,ぶん回せば12B前後まで.といった感じ.
おわりに
AMD Radeon RX 9060 XT を使って Ollama が動く環境の整備と,ざっくりとした限界性能を垣間見ることができた.
ちゃんとグラボとケースのサイズを確認しなかったおかげで,グラボ外装の両端を切り落とす荒療治が発生したのは内緒.
コメント